مقدمه
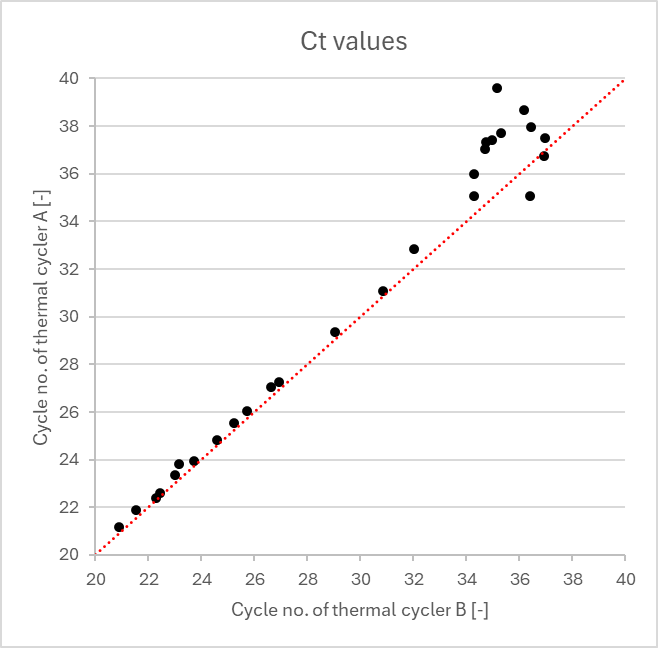
اگرچه این بار در مورد تایید یک روش دارویی نیست1من می خواهم به یک سوال جالب در مورد حد بالای خطی بودن پاسخ دهم. ما موضوع زیر را داریم: برای انجام واکنش زنجیره ای پلیمراز در زمان واقعی (RT-PCR) برای تشخیص SARS-CoV-2، باید مقایسه 2 ترموسایکلر مشخص شود. برای این منظور، مقادیر Ct دو ترموسایکلر (بیایید آنها را A و B بنامیم) در غلظت های مختلف نمونه بر روی یکدیگر ترسیم شد.
مقداری پس زمینه
برای پیدا کردن مقدار Ct (Ct = جچرخه تیآستانه)، مهم است که اصل واکنش PCR را در نظر داشته باشید. در حضور پرایمر، آنزیم DNA پلیمراز DNA تک رشته ای را گسترش می دهد تا یک رشته دوتایی تشکیل دهد. این رشته دوتایی متعاقباً با یک مرحله دناتوراسیون شکافته میشود و به پرایمرها اجازه میدهد تا با دو رشته جدید منفرد ارتباط برقرار کنند و یک بار دیگر گسترش یافته و رشتههای دوتایی جدید تشکیل شوند. از آنجایی که این فرآیند در بسیاری از چرخههای متوالی اتفاق میافتد، مقدار کمی از DNA قبلاً به صورت تصاعدی در این روش تقویت میشود. از آنجایی که محصولات تازه سنتز شده چرخه های قبلی به عنوان مواد اولیه برای چرخه های بعدی عمل می کنند، این واکنش زنجیره ای نامیده می شود. از آنجایی که در مورد ما DNA نیست بلکه RNA است که وجود دارد، رونویسی معکوس بالادست برای تبدیل RNA به DNA و در نتیجه امکان تجزیه و تحلیل ویروس های RNA انجام می شود.
در RT-PCR، مقدار Ct نشاندهنده چرخه تقویت است که در آن واکنش توصیف شده در بالا وارد فاز نمایی میشود و بنابراین از آستانه فراتر میرود (از نظر ریاضی، قبلاً چنین بود، اما واکنش هنوز قابل تشخیص نبود، بنابراین زیر آستانه بود).
بنابراین، مقدار Ct معیاری است – در مثال ما – غلظت RNA ویروس SARS-CoV-2 موجود در نمونه. مقدار کم Ct با غلظت RNA بالاتر ارتباط دارد زیرا چرخههای تقویت کمتری برای تشخیص در مقایسه با مقدار Ct بالاتر مورد نیاز است که در آن چرخههای بیشتری باید انجام میشد زیرا غلظت اولیه RNA در نمونه به طور قابلتوجهی کمتر بود.
بازگشت به مثال و سوال
نمودار مقادیر Ct دو ترموسایکلر به شکل زیر است:
هر چه نقاط منفرد به خط مستقیم نزدیکتر باشند، نتایج نمونه برای هر دو سیکلر حرارتی مشابه تر است. با این حال، مشاهده می شود که مقادیر شروع به واگرایی از مقدار Ct تقریباً می کنند. > 34.
به راحتی می توان دریافت که هرچه مواد ویروسی در نمونه اولیه کمتر باشد، پراکندگی بیشتر است، زیرا احتمال بدست آوردن دقیقاً همان مقدار RNA برای هر دو چرخه حرارتی در حین پیپت کردن کاهش می یابد. به همین دلیل، مقایسه دو سیکلر حرارتی فقط در محدوده خطی منطقی است.
این منجر به این سوال می شود: محدوده خطی روش به کجا ختم می شود، “حد بالای خطی بودن” چقدر است؟ چگونه این را به طور عینی تعیین کنیم؟
راه حل های ممکن
برای اینکه به طور متوالی نقاط تکی را حذف نکنیم، از انتهای بالای خط رگرسیون شروع کنیم و سپس بررسی کنیم که در کدام نقطه ضریب همبستگی R به 1 نزدیکتر است، اما برای فرو رفتن به انتهای موضوع، روشهای آماری مختلفی وجود دارد که میتوان از آنها استفاده کرد، مانند محاسبه پاسخ نسبی (عامل) یا تجزیه و تحلیل باقیمانده. دومی همچنین شامل تکنیک های آماری عمیق تر مانند تعیین مقادیر D (فاصله آشپزی) یا مقادیر H (مقادیر کلاه). راه های دیگری برای ارزیابی خطی بودن وجود دارد، اما فهرست کردن آنها در اینجا فراتر از محدوده این مقاله وبلاگ است. استفاده از تست های خطیمانند مواردی که برای بررسی خطوط کالیبراسیون استفاده می شود در این مثال معنایی ندارند.
بر این اساس، پاسخ نسبی و تحلیل باقیمانده برای مثال ما در تعیین حد بالای خطی در زیر ارائه شده است.
از آنجایی که ما مقادیر Ct سیکلر حرارتی A را در برابر B ترسیم کردیم، مقادیر Ct سیکلر حرارتی A به عنوان مقادیر y و مقادیر B به عنوان مقادیر x عمل می کنند. پاسخ نسبی به صورت y/x محاسبه می شود، برای باقی مانده yx را کم می کنیم.
|
مقدار Ct چرخه موضوعی B [-] (x [-])
|
مقدار Ct چرخه موضوعی A [-] (g [-])
|
واکنش نسبی [-] | باقیمانده [-] |
| 20.91 | 21.19 | 1.01 | 0.28 |
| 21.53 | 21.89 | 1.02 | 0.36 |
| 22.29 | 22.38 | 1.00 | 0.09 |
| 22.44 | 22.60 | 1.01 | 0.16 |
| 23.03 | 23.37 | 1.01 | 0.34 |
| 23.16 | 23.80 | 1.03 | 0.64 |
| 23.73 | 23.93 | 1.01 | 0.20 |
| 24.60 | 24.81 | 1.01 | 0.21 |
| 25.23 | 25.55 | 1.01 | 0.32 |
| 25.73 | 26.06 | 1.01 | 0.32 |
| 26.63 | 27.04 | 1.02 | 0.41 |
| 26.93 | 27.28 | 1.01 | 0.35 |
| 29.05 | 29.35 | 1.01 | 0.30 |
| 30.88 | 31.07 | 1.01 | 0.19 |
| 32.02 | 32.83 | 1.03 | 0.81 |
| 34.29 | 35.97 | 1.05 | 1.68 |
| ساعت 34.30 | 35.08 | 1.02 | 0.78 |
| 34.73 | 37.06 | 1.07 | 2.33 |
| 34.77 | 37،34 | 1.07 | 2.57 |
| 34.97 | 37.41 | 1.07 | 2.44 |
| 35.18 | 39.58 | 1.13 | 4.40 |
| 35.33 | 37.69 | 1.07 | 2.36 |
| 36.19 | 38.68 | 1.07 | 2.49 |
| 36.19 | 40.31 | 1.11 | 4.12 |
| 36.42 | 35.08 | 0.96 | -1.34 |
| 36.45 | 37.98 | 1.04 | 1.53 |
| 36.93 | 36.73 | 0.99 | -0.20 |
| 36.97 | 37,49 | 1.04 | 0.52 |
سپس میانگین پاسخ نسبی را محاسبه میکنیم (در اینجا: 1.031، با در نظر گرفتن همه مقادیری که ممکن است مورد سؤال قرار گیرند) و محدودیتهای مربوطه را تعیین میکنیم (در اینجا: تقریباً 3 ± درصد از میانگین، یعنی 1.000 و 1.062). مبنایی که محدودیتها بر اساس آن تعیین میشوند، و همچنین این سؤال که آیا همه مقادیر باید برای محاسبه میانگین استفاده شوند یا اینکه آیا مقادیر فردی باید از قبل بر اساس یک آزمایش پرت حذف شوند (و اگر چنین است، کدام یک)، باید در یک محیط تنظیمشده از طریق مشخصات داخلی، مانند رویههای عملیاتی استاندارد مربوطه پاسخ داده شود. در یک محیط غیرقانونی، توجیهات مرتبط در گزارش مطمئناً یک نقطه ضعف نخواهد بود ;-).
اگر اکنون داده های محاسبه شده (پاسخ نسبی و باقیمانده ها) را برای سؤال حد بالای خطی خود ترسیم کنیم، ممکن است مانند این باشد، برای مثال:
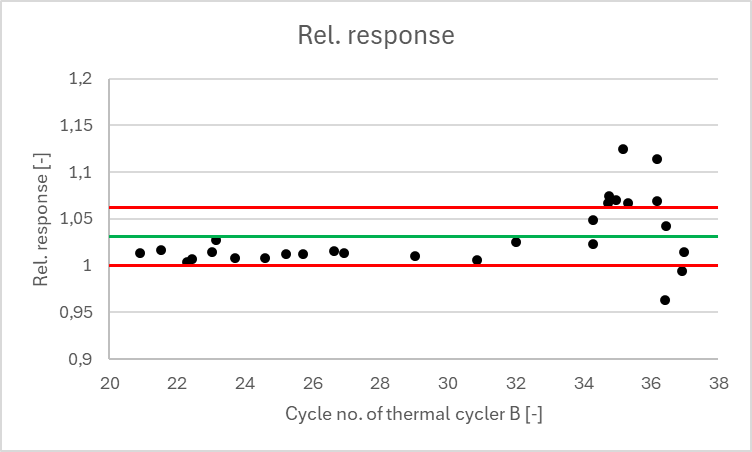
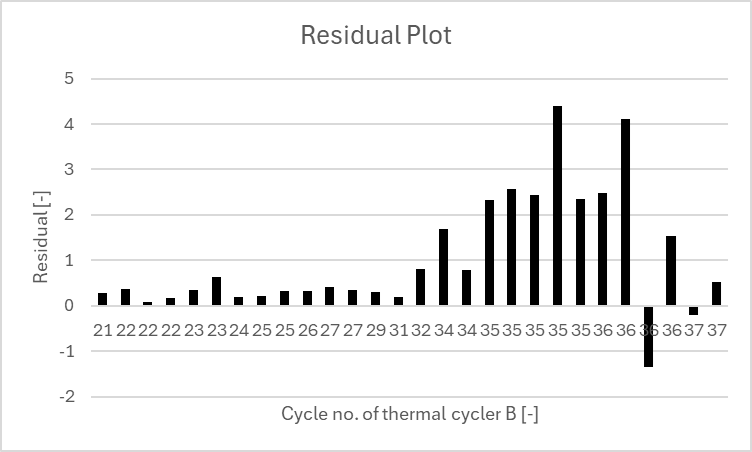
با ارزیابی دادهها با استفاده از پاسخ نسبی، میتوانیم ببینیم که مقادیر خارج از محدودیتهای (خود انتخاب شده!) هستند و از مقدار Ct 34.73 شروع میشوند، در حالی که بررسی نمودار باقیمانده اکنون یک ناهنجاری واضح را نشان میدهد که از مقدار Ct 32 شروع میشود. این نشان میدهد که مدل خطی دیگر با این بخش از دادهها مطابقت ندارد.
به طور خلاصه می توان گفت که حد بالایی خطی بودن را می توان به صورت عینی با استفاده از روش های آماری «پاسخ نسبی» و «تحلیل باقیمانده» تعیین کرد. کدام روش باید در نهایت با چه جزئیاتی در دستورالعمل های داخلی مشخص شده است استفاده شود یا باید توسط کاربر با توجیه مناسب تصمیم گیری شود.
1 بنابراین، میتوانیم با خیال راحت همه چیز را در مورد محدوده خطی معمولاً 80-120٪ (یا 70-130٪ برای یکنواختی محتوا) نادیده بگیریم، زیرا در اینجا مرتبط نیست.